
Introducción
La estructura que conocemos hoy como DNA (ácido desoxirribonucleico) fue descrita por Watson y Crick en el año 1953. A partir de esta propuesta, confluyeron ideas y nuevos enfoques experimentales que condujeron a lo que ha sido denominado como «dogma central de la biología molecular», en el que la información genética fluye del DNA al ARN (ácido ribonucleico) y de este a la proteína; por tanto, propone que es el DNA el material que almacena la información genética en unidades de información hereditaria denominadas genes. Aún cuando este enunciado es cierto para la mayoría de los seres vivientes; se ha comprobado que en determinados virus la información genética se almacena en forma de RNA, esta puede ser transferida del RNA al DNA a través de un proceso de transcripción inversa. Desde la propuesta de la doble hélice para la molécula del DNA, el conocimiento producido durante más de cuarenta años de investigación en la biología molecular, ha hecho posible el avance de las metodologías que permiten la manipulación del material genético de los organismos, a la vez que ha suscitado una de las mayores revoluciones en el pensamiento biológico como es la de poder entender, de manera más integral, la vida en nuestro planeta. En este contexto, tal vez uno de los mayores logros de la biología molecular en el siglo XX, fue el poder, de manera dirigida, manipular la información genética de los organismos incluyendo el hombre. Este enfoque tecnológico denominado tecnología del DNA recombinante, ha permitido un avance fundamental en la manera como se entiende actualmente el funcionamiento de los genes, en la posibilidad de corregir defectos genéticos y en la producción de nuevas alternativas terapéuticas, todo ello con el fin de mejorar la salud mundial. Sin embargo y a pesar de los grandes avances en estas áreas, existen riesgos potenciales que nos llevan a cuestionarnos cómo estos avances deben utilizarse y regularse para tener una bioseguridad en los protocolos, además de poder darles a todos los habitantes del planeta iguales oportunidades de utilización.
Estructura química del ácido desoxirribonucleico (DNA)
El DNA es un largo polímero (polinucleótido), formado por una serie de subunidades monoméricas denominadas los nucleótidos (figura 1). De acuerdo con el modelo actual más aceptado, el DNA es una doble cadena de polinucleótidos que se enrollan entre si para darle a la molécula de DNA una estructura helicoidal. Una doble cadena de DNA mide de 22 a 26 Å (2.2 a 2.6 nanómetros) de ancho, mientras que (un nucleótido) mide 3.3 Å (0.33 nm) de largo. Aunque cada unidad individual que se repite es muy pequeña, los polímeros de DNA pueden ser moléculas enormes que contienen millones de nucleótidos. Por ejemplo, el cromosoma humano más largo, el cromosoma número 1, tiene aproximadamente 220 millones de pares de bases.
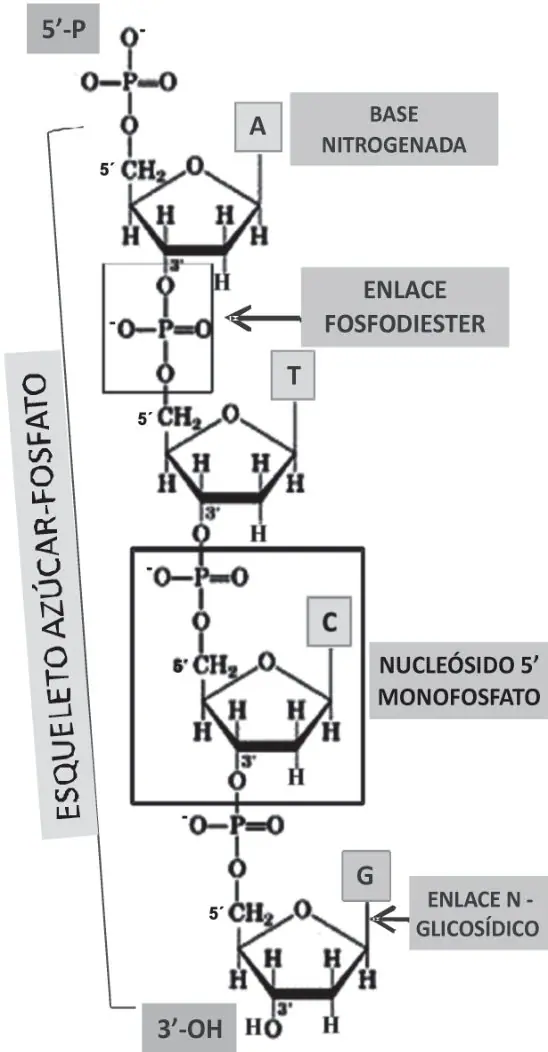
nucleotídica sobre la cual se construyen las moléculas de DNA de doble cadena. Cada uno de los nucleósidos 5´-monofosfato está unido mediante un enlace covalente denominado enlace fosfodiester. Este arreglo hace que la orientación de las desoxirribosas y los fosfatos formen un esqueleto azúcar-fosfato. Este contorno molecular del polinucleótido está cargado negativamente a pH fisiológico y tiene la capacidad de formar enlaces de hidrógeno con le agua. En la otra superficie la interna se dispone las bases nitrogenadas. Así pues el polinucleótido es capaz de tener dos superficies de contacto. El esqueleto azúcar-fosfato es hidrofílico, mientras que la disposición de las distintas bases nitrogenadas forma una superficie relativamente hidrofóbica.
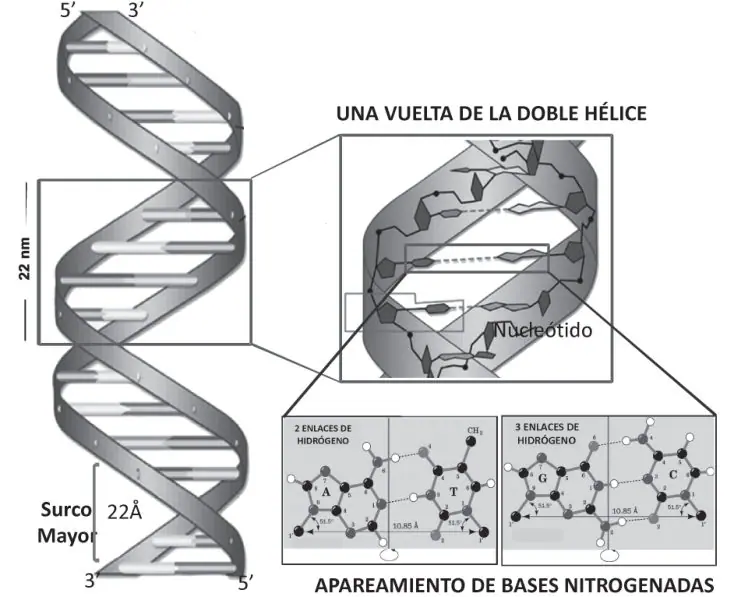
Laboratorio de Biología Molecular y Patogénesis. Departamento de Ciencias Fisiológicas. Escuela de Ciencias Básicas, Facultad de Salud, Universidad del Valle. Correo electrónico: labiomol@gmail.com El éxito del modelo de la doble hélice está en su consistencia con las propiedades físicas y químicas del DNA (figura 2). La estructura monomérica de soporte de una hebra de DNA es el nucleótido, este a su vez está compuesto de una molécula de azúcar que es una pentosa (la Desoxirribosa); una de cuatro bases nitrogenadas (Adenina, Guanina, Citosina, Timina) cuya unión covalente produce uno de cuatro nucleósidos diferentes. La unión de un grupo fosfato al nucleósido genera el nucleótido. El DNA como polímero está compuesto por largas cadenas de nucleótidos unidas covalentemente entre si por enlaces N-glicosídicos. Por esta razón es que el DNA es una doble cadena de polinucleótidos (figura 1). La doble hélice del DNA se mantiene estable mediante la formación de puentes de hidrógeno entre las bases asociadas a cada una de las dos hebras. Para la formación de un enlace de hidrógeno una de las bases debe presentar un «donador» de hidrógenos con un átomo de hidrógeno con carga parcial positiva (-NH2 o -NH) y la otra base debe presentar un grupo «aceptor» de hidrógenos con un átomo cargado electronegativamente (C=O o N). Los nucleótidos de cada una de las dos cadenas que forman el DNA establecen una asociación específica mediante puentes de hidrógeno con los correspondientes de la otra cadena. Cada tipo de base en una hebra forma un enlace únicamente con un tipo de base en la otra hebra, lo que se denomina «complementariedad de las bases». Según esto, las purinas forman enlaces con las pirimidinas, de forma que A se enlaza solo con T, y C solo con G. La organización de dos nucleótidos apareados a lo largo de la doble hélice se denomina apareamiento de bases (figura 2). Este apareamiento corresponde a la observación hecha por Erwin Chargaff quien mostró, que la cantidad molar de adenina era muy similar a la de timina; además que la cantidad molar de citosina era igual a la de guanina en el DNA. Esta observación permitió parearán mediante dos enlaces de hidrógeno; de otra parte si hay C en la complementaria habrá G y estas dos se unirán mediante tres enlaces de hidrógeno. La doble hélice se favorece termodinámicamente por la sumatoria de esto enlaces de hidrógeno, así la molécula de DNA de doble hélice es una estructura termodinámicamente estable pero flexible. En la doble hélice existirá un surco mayor. Cada vuelta de la doble hélice B incluye 10.5 pares de bases.
La doble hélice se estabiliza por el efecto hidrofóbico y el apilamiento de bases nitrogenadas; estos son independientes de la secuencia de bases del DNA. Como los puentes de hidrógeno no son enlaces covalentes, pueden romperse y formarse de nuevo dando una estructura dinámica. Por esta razón las dos hebras de la doble hélice pueden separarse como una cremallera, mediante fuerza mecánica o por alta temperatura. Como resultado de esta complementariedad, toda la información contenida en la secuencia de doble hebra de la hélice de DNA está duplicada en cada hebra, lo cual es fundamental durante el proceso de replicación del DNA. En efecto, esta interacción reversible y específica entre pares de bases complementarias es crítica para todas las funciones del DNA en los organismos vivos.
Existen dos tipos diferentes de apareamiento que ayudan a la estabilización de la doble hélice mediante la sumación de las energías de enlace de los pares de base complementarios. AT forman dos puentes de hidrógeno, y GC tres. El par de bases GC es por tanto, más fuerte que el par de bases AT. Como consecuencia, tanto el porcentaje de pares de bases GC como la longitud total de la doble hélice de ADN determinan la fuerza de la asociación entre las dos hebras de ADN. Así, dobles hélices largas de ADN con alto contenido en GC tienen hebras que interaccionan más fuerte que dobles hélices cortas con alto contenido en AT.
La doble hélice es una espiral dextrógira, esto es, cada una de las cadenas de nucleótidos gira a la derecha. Cuando las dos hebras de ADN se enrollan una sobre la otra, se forman huecos o hendiduras entre ellas, dejando expuestos los laterales de las bases nitrogenadas del interior (figura 2). En la conformación más común que adopta el DNA se generan, como consecuencia de los ángulos formados entre los azúcares de ambas cadenas de cada par de bases nitrogenadas, dos tipos de hendiduras superficiales: El surco mayor, que mide 22 Å (2.2 nm) de ancho, y la otra, la hendidura o surco menor, que mide 12 Å (1.2 nm) de ancho. Cada vuelta de hélice, que es cuando esta ha realizado un giro de 360º mide 34 Å, y en cada una de esas vueltas hay unos 10.5 pares de bases. Una de las características biológicas de doble hélice es que la secuencia lineal de nucleótidos tiene información biológica. Una proporción de ella está representada en los genes que se codifican por las diferentes proteínas que conforman nuestro cuerpo o hacen parte de los distintos procesos metabólicos. Así pues, la información genética que se transmite a las nuevas generaciones está contenida en la molécula de DNA que en el caso de los humanos, tiene un tamaño de más de 3.000 millones de estos nucleótidos combinados, producto de una evolución biológica.
Qué es un gen
El concepto de gen ha hecho parte fundamental del desarrollo del pensamiento biológico de los dos últimos siglos. Esto porque su definición es fundamental en los campos de la genética, la biología molecular, la evolución y recientemente en la genómica. La definición de gen fue evolucionando a medida que la biología encontraba nuevas evidencias sobre su estructura y función. Es así que el concepto de gen, lo podemos enmarcar en dos categorías principales: la abstracta y la física. El concepto abstracto se refiere principalmente a ciertos rasgos dentro de los que podemos incluir muchas de las enfermedades conocidas como monogénicas o de herencia simple mendeliana. En este sentido muchos de los biólogos evolucionistas y genetistas humanos clásicos utilizaron este concepto en una unidad de transmisión hereditaria. El concepto abstracto de gen se valida en lo que denominamos fenotipo, o sea el efecto biológico o rasgo detectable.
Con el desarrollo de la química de la herencia, a partir de los años cincuenta del siglo pasado, surge el concepto físico de gen, que lo define como una porción de DNA que está delimitado por una serie de secuencias consenso; en esa secuencia de nucleótidos delimitada, existe un mensaje que se expresa en una macromolécula funcional la cual es una proteína. Así podemos definir el gen desde el punto de vista físico como una secuencia de DNA que se transcribe a un RNA mensajero (mRNA) y del cual se sintetiza un producto funcional. Sin embargo esta definición tan exacta, tiene inconvenientes de ser general, a la luz de los nuevos hallazgos sobre el genoma humano y otros genomas de organismos tanto procarióticos como eucarióticos. Si miramos los nuevos conceptos con relación al papel que juega el RNA en la fisiología celular, la definición anterior queda corta pues al incluir un producto funcional, una proteína, excluye cualquier otro tipo de funcionalidad dentro de la célula. Si usamos una definición más general, un gen es una secuencia de DNA que es transcrita, existen diferentes tipos de genes: aquellos que codifican por secuencias lineares de proteínas y los genes que transcriben moléculas de RNA diferentes a los mRNA. En estos últimos, existe una gama muy amplia de RNA cuyas funciones no son solo participativas en la síntesis de proteínas si no en funciones tales como modificaciones postranscripción y replicación del DNA, reguladores, y como RNAs parásito. Todos ellos son transcritos a partir de regiones del genoma (genes RNA) de los organismos o son parte del procesamiento de transcritos de RNA.
El gen eucariótico
A diferencia de la estructura simple de un gen bacteriano, el cual contiene una secuencia promotora desde la que se inicia la transcripción de las secuencias de nucleótidos que codifican por la proteína, la organización de los genes de los organismos eucarióticos es mucho más compleja y flexible (figura 3).
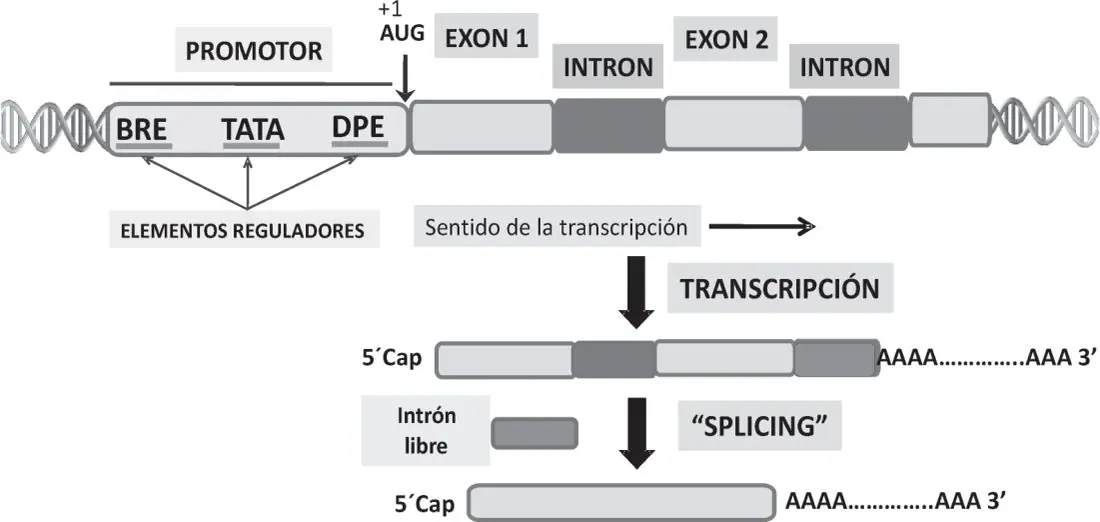
del gen propiamente dicho, está compuesto por una serie de secuencias consenso que regulan tanto el inicio de transcripción como los niveles de de síntesis de mRNA en la célula. Este elemento promotor se localiza «upstream» y no se incluye en el transcrito inicial. DPE, TATA y BRE son elementos que controlan la iniciación de la transcripción y están localizados dentro del promotor. En el sentido de transcripción «downstream» se localiza el gen que está divido en exones (secuencias que codifican por aminoácidos) e intrones, las cuales son espaciadoras de los exones. Durante el proceso de transcripción y procesamiento, se sintetiza inicialmente un transcrito primario que contiene tanto intrones como exones. Los intrones son removidos mediante el proceso de «splicing», empalmándose los exones para generar el mRNA que contiene una cola 3, de poliA y un nucleósido metilado el capuchón en su estremo 5,. Cuando se completan estos tres procesos, el mRNA está listo para su salida del núcleo al citoplasma y su traducción en los ribosomas.
De acuerdo con lo que se muestra en la figura 3, el gen eucariótico posee elementos de control de su propia transcripción; estos se localizan en la región «upstream» denominada promotor. Desde el punto de vista funcional, el promotor contiene una serie de secuencias reguladoras de la transcripción a nivel de tejido específico y también de regulación temporal. Además, más allá, corriente arriba del promotor, existen una serie de secuencias que se denominan potenciadoras (enhancers), que tienen como papel esencial mantener niveles cuantitativamente regulados de transcripción. Es fundamental diferenciar el promotor de bacterias del de los organismos eucarióticos. En estos últimos, se ha producido una proceso de evolución hacia una mayor complejidad pero ganando en funcionalidad y adaptabilidad. La región codificante del gen eucariótico está conformada por exones y está interrumpida por secuencias no codificantes o intrones. Aunque no es del caso entrar a discutir para qué son los intrones, ellos están en casi todos los genes eucarióticos que codifican por proteínas, con muy pocas excepciones. Podemos entonces afirmar que los intrones han hecho parte de la evolución del gen eucariótico. Durante el proceso de transcripción del gen, se produce un transcrito primario que contiene tanto exones como intrones. Sin embargo, los intrones son removidos y los exones unidos covalentemente, en un proceso denominado «splicing». En este proceso de remoción de intrones y unión de exones, participan una serie de ribonucleoproteinas («SNURP») que poseen un grupo especial de moléculas pequeñas de RNA denominadas URNA. Finalmente el proceso termina con el transporte de una ribonucleoproteína mensajera al citoplasma a través del complejo del poro nuclear.
Los genes pueden ser aislados y clonados mediante Ingeniería Genética
En 1973 A. C Chang, Stanley Cohen y Herber Boyer, hicieron público el primer experimento de DNA recombinante al unir un fragmento producido por la digestión con una enzima de restricción de un plásmido bacteriano de la bacteria Escherichia coli en el sitio de restricción homólogos de un plásmido completo. Un año más tarde, A. C Chang y Stanley Cohen aislaron fragmentos de DNA del cromosoma bacteriano de Staphylococcus y los ligaron covalentemente a un plásmido de E. coli, produciendo plásmidos quiméricos no conjugativos. Cuando estos plásmidos recombinantes se introdujeron en la bacteria E. Coli, lograron que los genes contenidos en los fragmentos de DNA de Staphylococcus se replicaran correctamente en este nuevo sistema genético de E. coli. Los resultados obtenidos en ese entonces, abrieron las puertas para el estudio detallado de la estructura y funcionamiento de genes tanto eucarióticos como procarióticos. Podemos concluir que la tecnología de la manipulación de la molécula de DNA ha avanzado dramáticamente en muy pocos años, llegando a tener una influencia no solo en la ciencia básica sino en las aplicaciones biotecnológicas que han revolucionado la industria y la economía mundiales.
La técnica del DNA recombinante
La metodología que permite reconstruir moléculas de DNA por unión de secuencias de nucleótidos de una gran variedad de organismos a un sistema genético de replicación autónoma denominado vector, se describe como Ingeniería Genética o Técnica del DNA Recombinante (el término ingeniería genética es coloquial siendo más apropiado describirlo como DNA recombinante). El desarrollo de la técnica del DNA recombinante fue posible gracias a los estudios previos efectuados durante treinta años en la exploración molecular de los procesos genéticos y celulares. Por esta razón se ha convertido en una serie de metodologías que tienen como objetivo poder manipular de manera parcial la información genética de los organismos. Sin embargo como cualquier tecnología, la Ingeniería Genética, requiere del empleo de una serie de procesos biológicos controlados y de herramientas moleculares para poder llevar a cabo experimentos en este campo. Por esta razón decimos que la técnica del DNA recombinante necesita para su aplicación de una «caja de herramientas», dentro de las que se incluyen moléculas de DNA vectoras, enzimas que hidrolizan el DNA (Endonucleasas de Restricción), enzimas que polimerizan del DNA (DNA polimerasas), aquellas que ligan covalentemente moléculas de DNA (DNA ligasas) y otras que tienen como objetivo completar los procesos de clonación molecular. A continuación haremos una descripción general de esta caja de herramientas moleculares y cómo se pueden obtener resultados aplicables tanto a la investigación básica como a aquella que involucra una mejora en el funcionamiento de los organismos especialmente en los humanos.
Endonucleasas de restricción los «escalpelos moleculares» para cortar el DNA
La técnica del DNA recombinante utiliza de manera exitosa las endonucleasas de restricción; estas son enzimas bacterianas cuya expresión es inducida por la infección de ciertos bacteriófagos a cepas específicas de bacterias. Este proceso definido como restricción/modificación tiene como resultado la síntesis de una endonucleasa de restricción que «ataca» y fragmenta el DNA infectante. Por otro lado, una enzima de modificación, generalmente una que adiciona grupos metilo a ciertas bases nitrogenadas denominada DNA metilasa, protege el DNA bacteriano de ser destruido por su propia endonucleasa de restricción. Todas las endonucleasas de restricción reconocen secuencias específicas de nucleótidos sobre un sustrato que es una molécula de DNA de cadena doble. Existen tres clases principales de estas enzimas denominadas ER I a III. Las endonucleasas de restricción de las clases I y III son enzimas que reconocen una secuencia específica larga de ocho o más nucleótidos, pero su acción hidrolítica endonucleásica se realiza en algunos nucleótidos externos a este sitio de reconocimiento. Todas las enzimas del tipo I requieren para su actividad nucleásica, de la hidrólisis de una molécula de ATP, además de S-adenosilmetionina (SAM) y Mg++ como cofactores. Debido a que su mecanismo de corte es bastante amplio, este grupo de endonucleasas no son útiles para las experiencias de DNA recombinante. En este sentido, las endonucleasas de restricción de la clase II son, por su especificidad, las empleadas en todos los experimentos de clonación molecular.
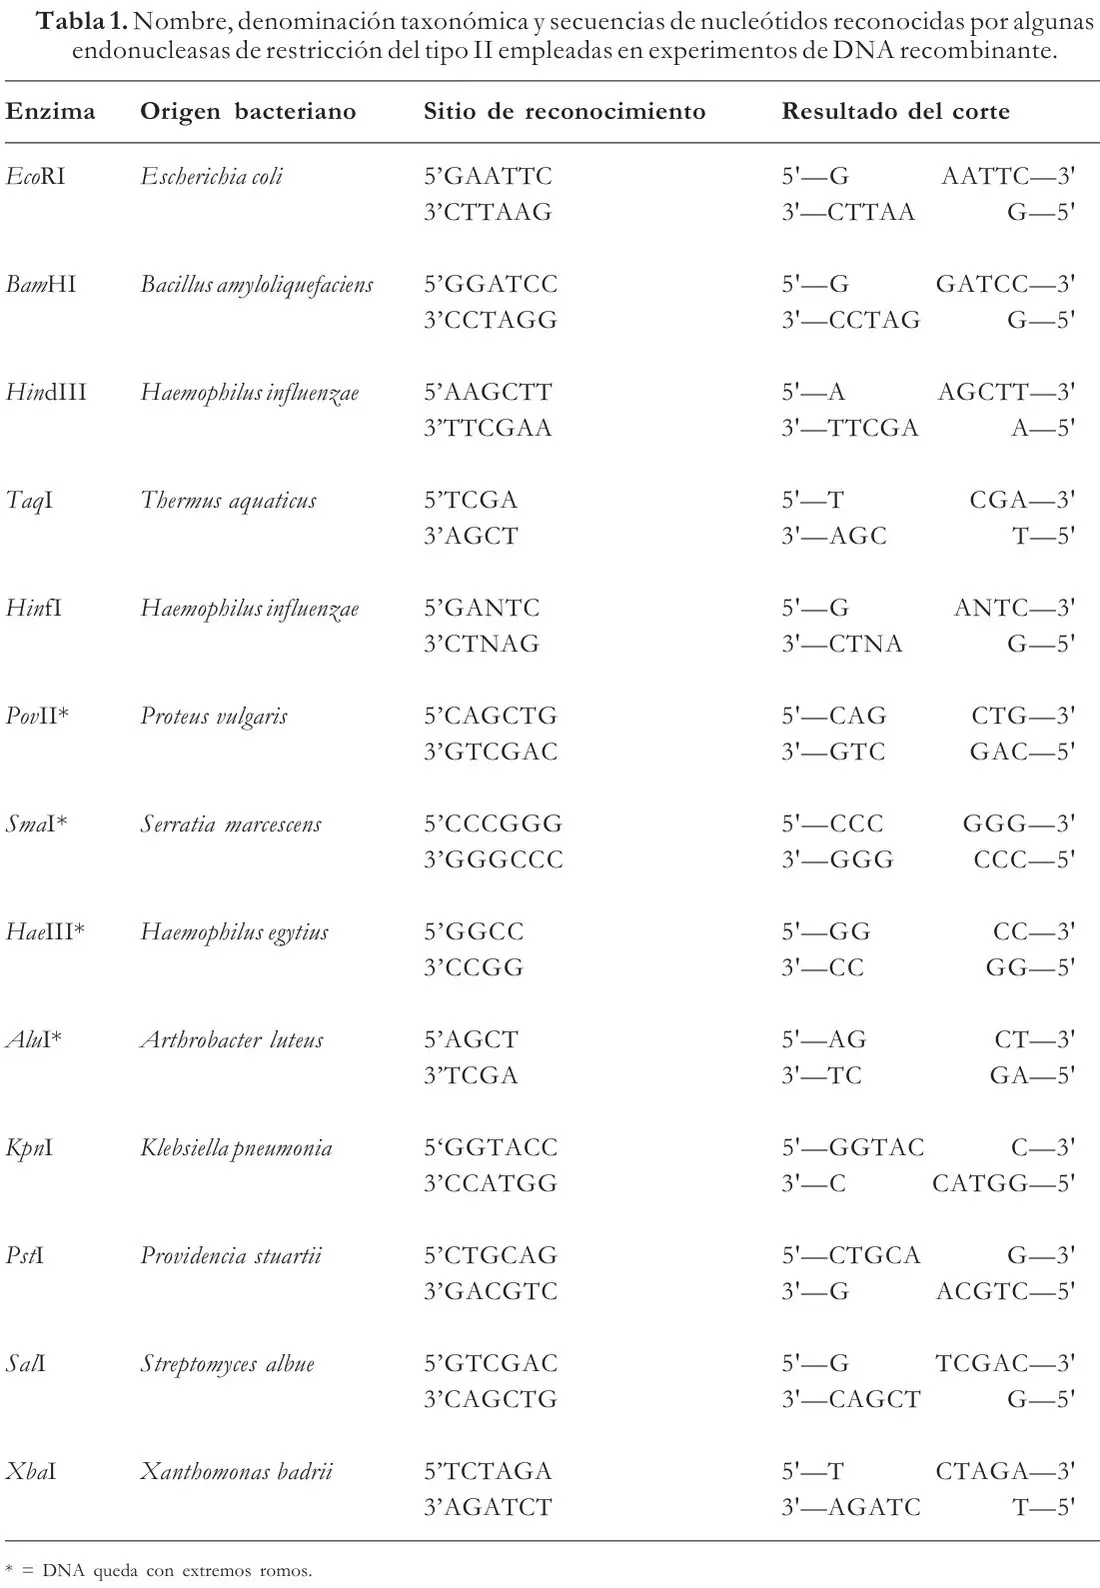
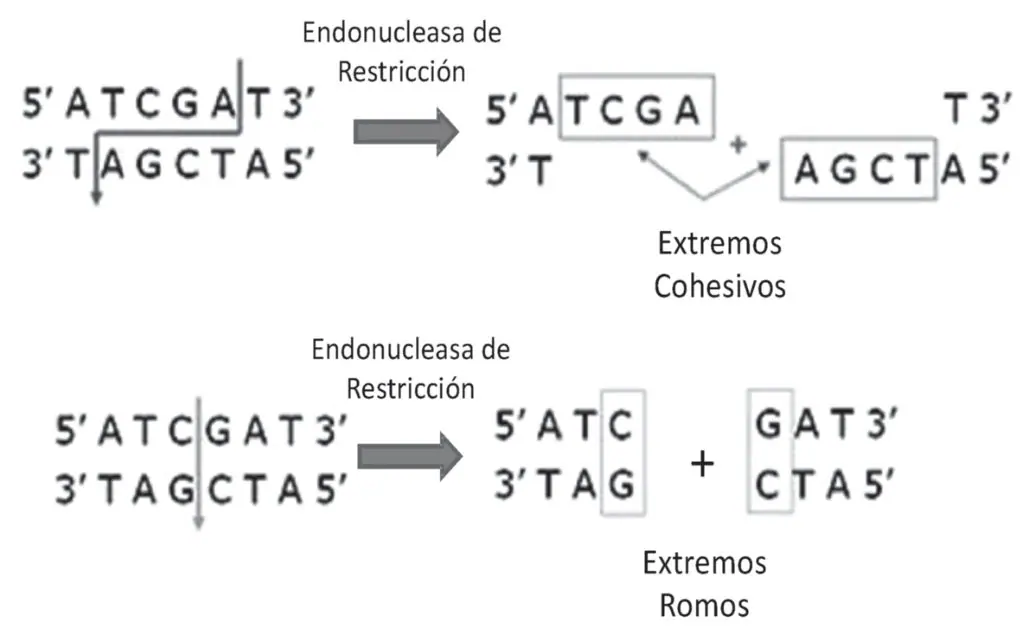
Las endonucleasas de clase II, se convierte en una especie de «bisturí molecular« que corta el DNA en sitios específicos los cuales contienen secuencias de nucleótidos que varían de cuatro a seis pares de bases. La secuencia del sitio blanco, determina la especificidad de reconocimiento de la correspondiente endonucleasa de restricción; actualmente se conocen aproximadamente 350 diferentes enzimas de restricción que poseen especificidades de secuencia muy variables. Para la clasificación y sistematización de las ER, su denominación taxonómica contiene características de la especie bacteriana o cepa de la cual fue aislada. Por ejemplo Eco RI es una enzima de E. coli que contiene el plásmido R. Tal como hemos descrito anteriormente las endonucleasas de restricción del tipo II siempre reconocen secuencias de 4 a 6 nucleótidos; en la portantes de algunas de las endonucleasas de Que corresponde al sitio de unión de la EcoRI, existe un eje imaginario de simetría a partir del cual la secuencia se lee lo mismo en ambas cadenas en la dirección 5,→3,. Este arreglo de secuencias es lo que se define como un «palíndrome».

Algunas enzimas de restricción cortan en la mitad del sitio de reconocimiento y producen extremos romos («flush ends»), tal es el caso de Hae III, Alu I, Sma I y Pov II descritas en la tabla presentada y representadas gráficamente en la figura 4. En otras el corte no se produce en el centro del palindrome sino que la hidrólisis de los enlaces fosfodiester ocurre de 3 a 5 nucleótidos más allá; el efecto es la generación de segmentos muy cortos de DNA de una sola cadena, que pueden aparearse entre sí (figura 4). Estos extremos denominados «pegajosos» («sticky ends») son susceptibles de unirse a cualquier otro fragmento de DNA que hubiese sido cortado por la misma enzima o un isoesquisómero de ella, constituyéndose así en un instrumento ideal para la Ingeniería Genética.
Los vectores de clonación molecular
Un vector de clonación, es un sistema genético replicante cuya replicación es autónoma e independiente de la de otros sistemas coexistentes. Así pues, la definición de vector restringe a ciertas moléculas de DNA como plásmidos, virus o derivados de ellos, la gama de vectores que se emplean actualmente para los experimentos de DNA recombinante. Como cualquier sistema replicante, un vector debe poseer un origen de replicación que le permita su duplicación autónoma del DNA cromosómico de la célula que lo aloja y también debe contener marcas genéticas que permiten la selección de la célula que los contiene. La clonación de un fragmento de DNA en un vector permite producir cantidades DNA recombinante a partir de una molécula original. Se define un clon como una población de moléculas o células todas idénticas con relación a una molécula o célula ancestral original. Por esta razón a la técnica de DNA recombinante también se le denomina clonación molecular. La clonación de DNA se puede realizar gracias a la capacidad que poseen los plásmidos bacterianos y fagos para continuar sus «estilos de vida usuales» una vez que se les han insertado secuencias de DNA foráneo a sus genomas. Una inserción de DNA genera un vector híbrido o quimérico que consiste en parte de DNA del genoma original y una parte de secuencias adicionales o «foráneas». Estos elementos quiméricos replican en bacterias de forma similar a los vectores no recombinantes, de esta forma se pueden obtener grandes cantidades de un fragmento foráneo clonado en estos.
Para clonar DNA existen una serie de vectores, los cuales han sido objeto de manipulación, que incluyen una gama muy amplia de plásmidos bacterianos derivados y modificados de contrapartes naturales, bacteriófagos dentro de los que se incluye una amplia de modificados del bacteriófago Lambda, del M13 y de otros. Además una serie muy importante de vectores de clonación contienen elementos genéticos derivados de sistemas eucarióticos, que permiten la manipulación y expresión de genes bajo condiciones de expresión eucarióticas. Finalmente se han desarrollado vectores derivados de virus de animales y plantas, los cuales se emplean para producir organismos transgénicos y en la terapia génica que revisaremos más adelante.
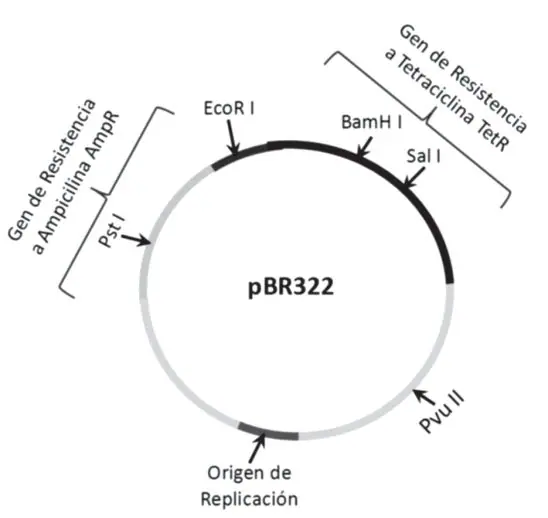
Los plásmidos, son quizá los vectores más utilizados. Estos son moléculas circulares de DNA que se replican de manera independiente al cromosoma de la célula hospedera. De manera natural se encuentran en las bacterias en tamaños que van desde 5,000 hasta 400,000 pb. Existen dos tipos generales de sistemas de control de replicación del plásmido: aquellos de copia única son mantenidos a niveles de 1 plásmido por bacteria en contraste con los multicopia que se encuentran en niveles mucho mayores, típicamente de 10 a 20 genomas por célula. El plásmido pBR322 es uno de los más célebres que existen, por ser el primer plásmido diseñado y utilizado en biotecnología. Aunque se basa en un andamiaje natural, le fueron agregados genes para realizar las funciones que el investigador requería. Construido por Francisco Bolívar y Raymond Rodríguez de la Universidad de Stanford, se convirtió en una de las primeras herramientas para la introducción de genes específicos en una bacteria. El pBR322 cuyo tamaño es de 4361 pares de bases, posee un gen de resistencia a la ampicilina que le confiere a la célula portadora del plásmido la capacidad de crecer en un medio bacteriológico con dicho antibiótico, esta resistencia se destruye cuando este se somete a tratamiento con EcoRI. Es así que si un DNA es clonado en este sitio, el recombinante es sensible al tratamiento con este antibiótico pero conserva la resistencia a tetraciclina (figura 5). Este doble juego permite establecer un sistema muy rápido y sencillo de seleccionar clones recombinantes cuyos fragmentos de DNA clonados han sido ligados en este sitio. Este procedimiento se denomina «selección negativa», porque se busca que la colonia de bacterias o levadura pierda una función; en este caso, la de resistir a la ampicilina.
Se han construido muchos plásmidos para ser usados como vectores de clonación. La gran mayoría de ellos reúnen varias características genéticas bacterianas o de sistemas virales eucarióticos, estas permiten desarrollar estrategias de tamizado de secuencias específicas clonadas. Como se ha descrito antes, talvez, la estrategia más común es el uso de plásmidos vectores que portan genes que especifican por resistencia a antibióticos. Esta característica fue exitosa en el diseño de un sistema de clonación. Sin embargo, no es la única manera de tener un sistema de tamizado. A partir de la introducción de genes que codifican por enzimas cuya actividad puede ser fácilmente monitoreada, se han construido una serie de vectores que expresan la beta-Galactosidasa. Esta enzima hidroliza la lactosa en sus dos monosacáridos glucosa y galactosa. La actividad enzimática puede ser trazada utilizando un sustrato artificial acoplado a una molécula que da una reacción coloreada (azul). Si el DNA foráneo es clonado cerca de un sitio de restricción que inactiva la enzima, los clones recombinantes dan una reacción negativa que se traduce en una colonia blanca en contraposición a las no recombinantes que expresan un color azul.
Construcción de bibliotecas de DNA recombinante
El primer paso hacia la identificación de un gene en particular es digerir el genoma que lo contiene en fragmentos manejables de acuerdo con el vector escogido. Lo deseable es que el gene se encuentre localizado en uno de estos fragmentos. La capacidad de clonación de un vector la cual se define como el tamaño máximo que se puede ligar en un vector sin alterar su capacidad replicativa varía dependiendo del sistema de clonación utilizado. El tamaño manejable oscila, de acuerdo al sistema, pero para los plásmidos es de máximo diez mil pares de bases. Debido al tamaño relativamente grande de los genomas de muchos organismos, el DNA a clonar se fragmenta en pedazos de tamaño aceptable; esta colección de fragmentos se liga a vectores apropiados con el objetivo de construir una biblioteca de clones recombinantes o geneteca. Dentro de la colección de vectores quiméricos habrá uno que tendrá el fragmento que contiene el gene que se quiere aislar. El problema se centra en la metodología a utilizar en la selección del clon recombinante correspondiente. Para tal fin se han desarrollado varios enfoques experimentales, dentro de los cuales el más comúnmente utilizado es la hibridización de colonias de bacterias recombinantes o de placas de lisis de bacteriófagos recombinantes que han crecido sobre superficies sólidas de agar.
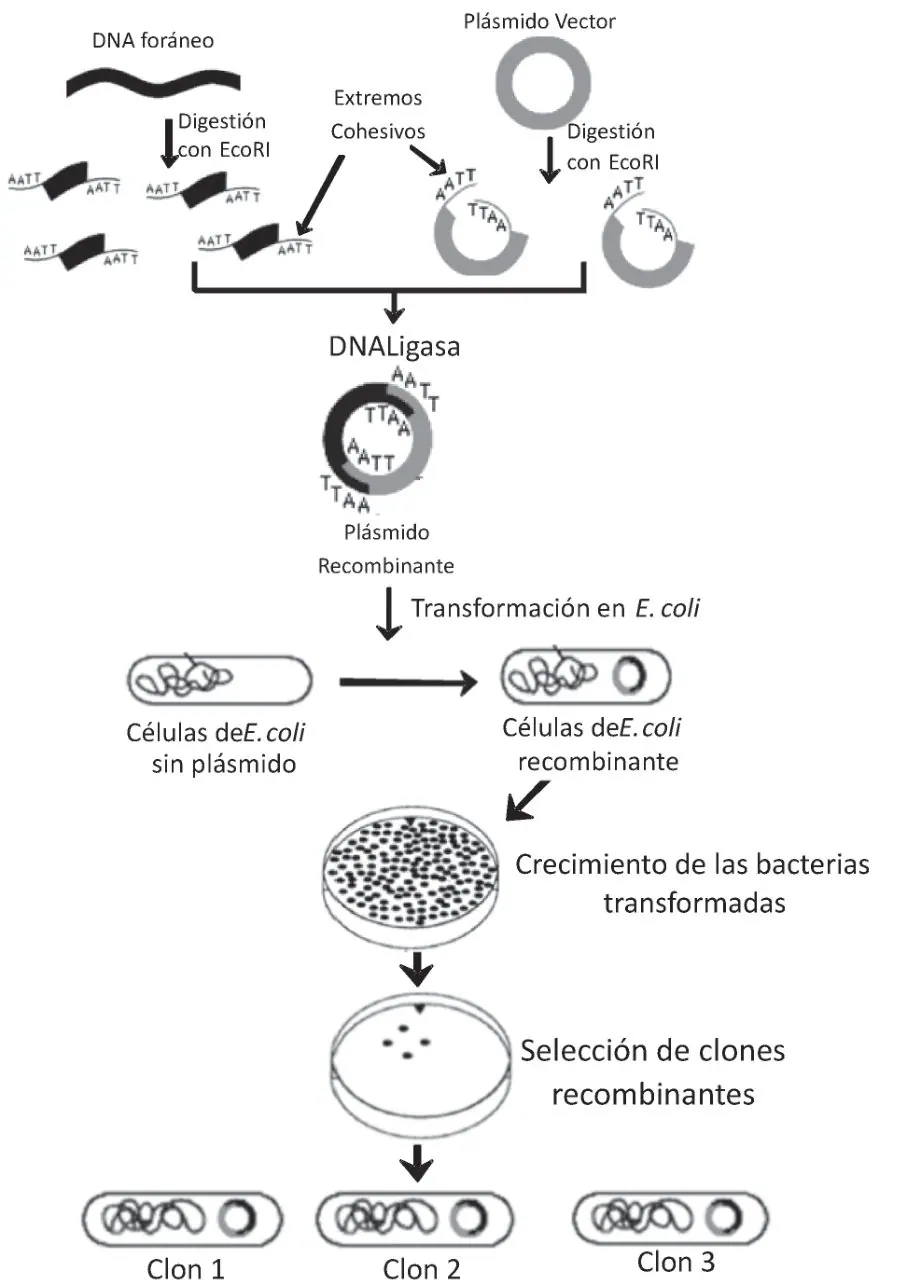
El protocolo de clonación molecular más sencillo es emplear una endonucleasa de restricción que produzca cortes que generan extremos cohesivos tanto en el vector como en el DNA foráneo. El ejemplo clásico es la enzima EcoRI tal como ya ha sido explicado en las secciones anteriores. Posteriormente las secuencias complementarias de los dos extremos de cada DNA se alinean (puesto que estos extremos son homólogos); después del alineamiento, en las moléculas recombinantes se sellan los huecos dentro del vector quimérico con DNA ligasa de T4 (figura 6). Una ventaja de este procedimiento es que no se pierde el sitio de EcoRI, sirviendo como referencial para el estudio y estimación de tamaño del fragmento clonado.
El RNA mensajero puede ser copiado a cDNA
Con el fin de obtener una secuencia de DNA que represente el codificado de una proteína particular, el enfoque ideal es comenzar con su correspondiente mRNA el cual después de todo, es el molde empleado para la traducción en la proteína in vivo. La existencia de la transcripción reversa (por la transcriptasa reversa AMV, del virus de la mieloblastosis aviar, enzima que copia una cadena de DNA a partir de un molde de RNA), es una opción que se emplea para resolver esta clase de problemas en la clonación de secuencias de DNA. La transcripción reversa es extremadamente fácil para mRNAs que posean colas de poli (A) en su extremo 3, (al igual que otras enzimas que sintetizan DNA, la transcriptasa reversa no puede iniciar la formación de una cadena polinucleotídica sin un extremo cebador) (figura 7).
El producto de reacción de la transcriptasa reversa, es una molécula de DNA de doble cadena complementaria al mRNA que se utilizó como molde. El único problema práctico es la tendencia que tiene la transcriptasa reversa in vitro a detenerse en varios puntos antes de alcanzar el extremo 5,. Otra característica importante de esta enzima es que cuando alcanza el terminal 5,, se desliza de 10-20 bp por fuera del molde, generando un gancho. Este puede ser empleado para iniciar la síntesis de la banda de DNA complementaria. En esta unión el RNA se degrada por tratamiento con álcali, para producir un DNA copiado (cDNA) de una cadena complementaria al mRNA molde usado. Posteriormente la misma transcriptasa o la DNA polimerasa I de E. coli convierte el cDNA de simple cadena en un DNA dúplex. El producto final es un DNA de doble cadena que contiene el «gancho» del extremo 5,. Este se degrada por el tratamiento in vitro con la enzima nucleasa S1 (que hidroliza específicamente DNA de cadena única), así se restablece la estructura de doble hélice con los extremos 5´ libres.
¿Cómo encontrar un gen en una biblioteca de DNA recombinante?
Una de las metodologías más usadas para la selección de clones recombinantes, es el empleo de sondas o rastreadores que tengan alguna homología de bases con el gene a seleccionar. En este punto se ve la importancia de los clones de cDNA, pues si previamente se ha caracterizado el producto de transcripción del gene en cuestión, es posible sintetizar y clonar su cDNA. Así, empleando la metodología de hibridación de secuencias homólogos, se puede «pescar» de la geneteca el clon recombinante que porte el gene. En términos prácticos la selección de clones recombinantes se realiza por técnicas de plaqueo de la colección de recombinantes. En resumen esta metodología consiste en: 1. Crecimiento una densidad de colonias apropiadas para individualizarlas en la caja de Petri. 2. Transferencia del DNA de cada colonia a filtros de nitrato de celulosa o de Nylon previa desnaturalización en condiciones alcalinas y obtener mediante la técnica de DNA recombinante clones quiméricos a partir de un DNA foráneo. En los primeros pasos se somete a digestión con la misma Endonucleasa de restricción tanto el DNA foráneo como el plásmido vector. Una vez linearizado el plásmido vector, se mezclan las dos poblaciones de moléculas digeridas que tienen extremos cohesivos complementarios y se incuban con la DNA ligasa del bacteriófago T4. La reacción de ligación produce plásmidos recombinantes conteniendo porciones de genoma foráneo utilizado. A partir de estas bacterias recombinantes que conforman una biblioteca de DNA recombinante, se seleccionan clones recombinantes que son propagados en medios de cultivo apropiados. Posteriormente mediante utilización de una sonda de DNA específica, se busca el clon recombinante que contenga el fragmento homólogo a la sonda. De esta manera se purifican y estudian los plásmidos quiméricos.
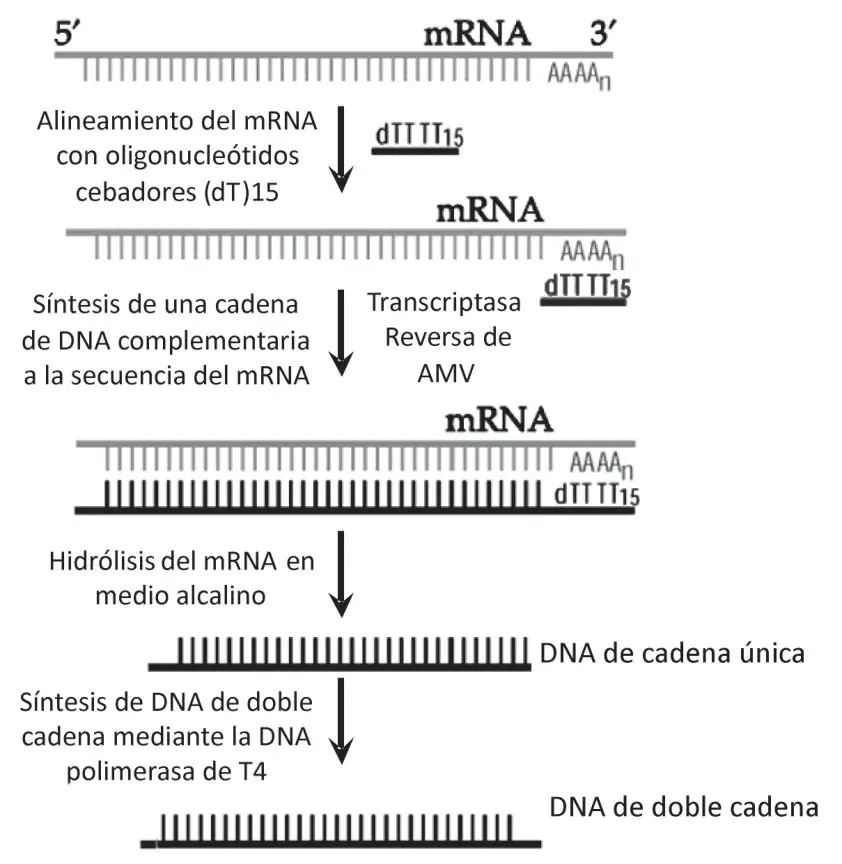
mRNA eucarióticos; de esta manera la transcriptasa reversa completa la síntesis de una molécula de cDNA complementaria. Posteriormente la DNA polimerasa de T4 completa la síntesis de la segunda cadena para producir un sustrato de DNA de doble cadena a ser clonado en vectores apropiados.
posterior neutralización. El DNA de cada colonia es sometido a hibridización con la correspondiente sonda previamente marcada, bien sea radiactivamente o por procedimientos no radioactivos, en condiciones fisicoquímicas apropiadas para que ocurra el apareamiento de porciones de nucleótidos de la sonda con el DNA clonado en el recombinante. Después de una serie de lavados, en condiciones de sal necesarias para retirar los híbridos inespecíficos, (este efecto se denomina astringencia), los filtros son sometidos a procedimientos de revelado con el fin de localizar las colonias que contienen DNA complementario a la sonda empleada (figura 8).
Transferencia e hibridización de DNA en «Southern»
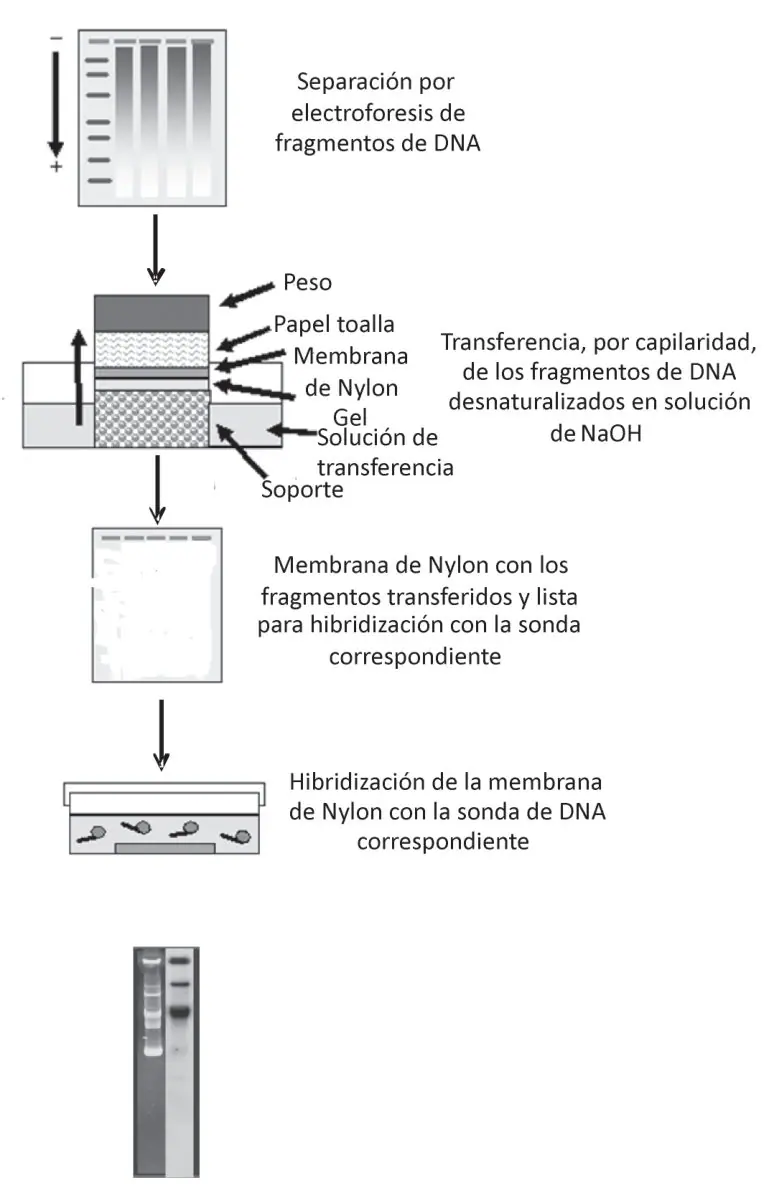
Una de las técnicas más utilizadas para identificar y estudiar estructuralmente genes que han sido clonados, es la técnica de transferencia e hibridización en Southern desarrollada por Southern en 1968. Esta metodología combina la separación electroforética de moléculas de DNA en geles de agarosa con la posterior transferencia de éstas a membranas de Nitrocelulosa (NC) o de Nylon. Es importante destacar que solamente el DNA de cadena única se une a la membrana de manera estable, por lo cual hay que tratar los Figura 8. Descripción del método de hibridización en colonias empleado para seleccionar clones recombinantes a partir de una colección inicial de recombinantes. El objetivo es identificar clones recombinantes que tengan fragmentos de DNA complementarios a sondas de DNA específicas mas utilizadas. El revelado en la membrana de Nylon, permite volver a la placa con las bacterias y obtener el clon recombinante bacteriano.

fragmentos con soluciones desnaturalizantes que permitan la generación de fragmentos de cadena única. Al transferir los fragmentos, separados de acuerdo con su tamaño molecular, a membranas NC es posible hibridizarlos utilizando para ello una sonda de DNA que tenga secuencias complementarias al gene que se desea estudiar. Las condiciones son muy semejantes a las previamente descritas para la hibridización de colonias (figura 9).
Recientemente se han desarrollado varias metodologías de transferencia de otras moléculas que tienen casi el mismo principio del Southern. El Northern es la técnica de transferencia de poblaciones de RNA a membranas de NC o de Nylon. El Western es la forma de transferir proteínas de geles de poliacrilamida a membranas de NC, proteínas de geles de poliacrilamida a membranas de NC. A medida que se van perfeccionando las técnicas de detección, se hace más fácil aislar y estudiar genes. En los últimos años ha sido perfeccionada una de las metodologías más potentes, la síntesis de secuencias de oligo-nucleótidos in vitro. Empleando este enfoque, es posible sintetizar cualquier sonda, pues basta conocer parcialmente la secuencia de aminoácidos de una determinada proteína. Esta sonda sirve de base para aislar el gene de una geneteca.
La secuenciación del DNA
La secuenciación de DNA incluye un conjunto de métodos y técnicas bioquímicas cuya finalidad es la determinación del orden de los nucleótidos (A, C, G y T) en un oligonucleótido de DNA. Determinar la secuencia de DNA es útil en el estudio de la investigación básica de los procesos biológicos fundamentales, así como en campos aplicados, como la investigación forense. El desarrollo de la secuenciación del DNA ha acelerado significativamente la investigación y los descubrimientos en biología.
Las técnicas de secuenciación actuales permiten realizar esta secuenciación a gran velocidad, lo cual ha sido de gran importancia para proyectos de secuenciación a gran escala como el Proyecto Genoma Humano. Otros proyectos relacionados, en ocasiones, fruto de la colaboración de científicos a escala mundial, han establecido la secuencia completa de DNA de muchos genomas de animales, plantas y microorganismos.
Aplicaciones de la técnica de DNA recombinante
Aunque las aplicaciones de la Ingeniería Genética cubren casi la totalidad de los procesos en plantas y animales, la medicina y la salud humana, son quizá los campos de aplicación más beneficiados con el descubrimiento y la implementación de la tecnología de DNA recombinante, puesto que esta ha permitido descubrir y buscar alternativas y tratamientos para numerosas enfermedades, la detección temprana de enfermedades genéticas, la producción de sustancias y medicamentos revolucionarios y como complemento a todo esto se ha desarrollado también terapias génicas para algunas de las enfermedades que aquejan diariamente a miles de personas. Es importante resaltar que aunque existe una gama muy importante de productos de DNA recombinante que tienen usos benéficos para la especie humana y el planeta, se vislumbra una posibilidad real de que algunas de las aplicaciones generen productos nocivos o destructivos para el hombre y el planeta. Nos referimos a una realidad que existe en el armamento biológico almacenado en algunas de los laboratorios de investigación y aplicación en muchos de los países desarrollados y que son más peligrosos que las mismas armas nucleares de destrucción masiva. Por esta razón y desde 1976, año en que se llevó a cabo la Conferencia de Asilomar en California, existen lineamientos bioéticos y de seguridad biológica obligatorios para desarrollar experimentos de DNA recombinante.
Producción de proteínas recombinantes
La Ingeniería Genética ha abierto la posibilidad de emplear bacterias y otros microorganismos para producir proteínas de importancia económica, médica e industrial. Esto ha posibilitado el desarrollo una de las más nuevas fronteras de conocimiento en la genética y la biología molecular. Una proteína recombinante es aquellas que se expresa como parte de un construido generado por clonación molecular en un sistema biológico. Generalmente estas proteínas se expresan en sistemas biológicos en los que naturalmente no existe su síntesis, por lo que es una información genética nueva que se expresa empleando la maquinaria biosintética de la célula que contiene el construido. La producción de proteínas recombinantes ha abierto una gran frontera para la obtención de organismos biofábricas que sintetizan proteínas recombinantes de interés biotecnológico. Recientemente se ha documentado la clonación de genes de proteínas de importancia médica como la insulina, la somatostatina y la eritropoyetina, entre otros, lo que ha permitido el inicio de una nueva era de la industria farmacéutica en la que los fármacos, proteínas recombinantes, se producen por sistemas de crecimiento de organismos biofábrica. Con esta visión la industria farmacéutica actual ve la importancia de implementar procesos menos contaminantes y con costos de producción menores. Además uno de los problemas más importantes de la agricultura moderna, es el empleo de insecticidas y controladores de plagas, pues la utilización de estos compuestos además de incrementar costos de producción también aumenta el peligro de contaminación del ecosistema y por ende trae consecuencias importantes para la salud humana. Una de las alternativas viables para resolver esta problemática es la introducción de genes de fijación de nitrógeno y otros genes como los de resistencia en bacterias que habiten en las raíces de plantas no leguminosas con lo que se eliminaría el uso de fertilizantes nitrogenados o de pesticidas y controladores de plagas. Uno de los elementos centrales en la implementación de los procesos biotecnológicos antes mencionados, es el desarrollo de sistemas de expresión modulada de genes, los denominados vectores de expresión.
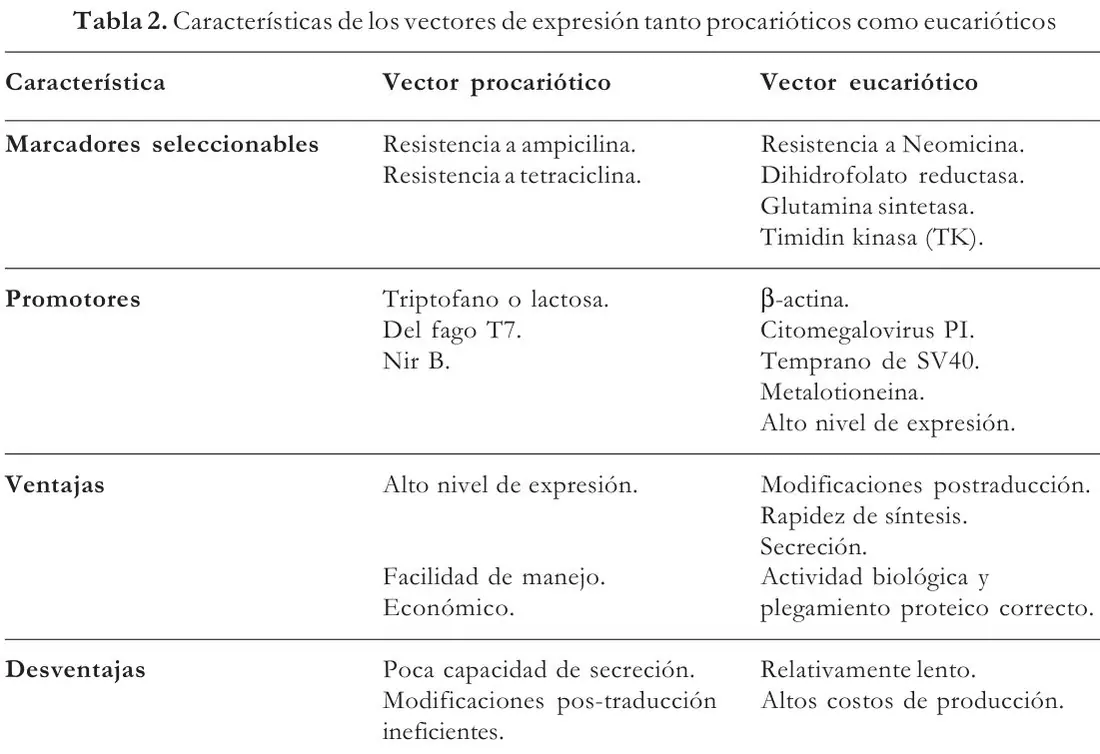
Tal como habíamos descrito en secciones anteriores, lo vectores de expresión son un aspecto fundamental para la producción de proteínas recombinantes. De acuerdo con lo que se muestra en la tabla 2 existen varios elementos genéticos que hacen parte de este grupo de los vectores de expresión tanto en los sistemas procarióticos como el los eucarióticos. Estos son requisitos mínimos que debe tener un vector de expresión. En general las funciones algunos de ellos son similares, lo que cambia es su capacidad para expresar la proteína recombinante en un huésped procariótico (bacteria) o en uno eucariótico (células en cultivo). El uso de productos recombinantes tiene ventajas importantes en comparación con el empleo de material extraído de tejidos, especialmente en lo que se refiere a proteínas humanas. Con frecuencia la fermentación de bacterias en biorreactores produce cantidades importantes de proteína a bajos costos y con relativa pureza. Se obvian pasos en la síntesis química o en la extracción que utilizan reactivos potencialmente nocivos para la salud. Este aspecto es fundamental en el control de calidad, el cual es más fácil y seguro para la producción de un agente terapéutico vía DNA recombinante.
Hasta el momento, la clonación de muchos genes eucarióticos en vectores de expresión bacteriana ha traído problemas tecnológicos pues las proteínas recombinantes producidas no parecen expresarse en forma correcta. Este hecho ha impulsado la construcción y desarrollo de nuevos vectores de expresión que contienen promotores de origen eucariótico presentes en virus animales o en genes humanos aislados previamente. Con la utilización de vectores de expresión eucarióticos ha sido posible la expresión y producción comercial de la Insulina humana recombinante y de la Somatostatina humana de origen recombinante entre muchas de las proteínas recombinantes utilizadas actualmente en el tratamiento de enfermedades humanas. La tabla 3 consigna las características de algunas proteínas que se emplean hoy como agentes terapéuticos. Muchos de ellos ya se encuentran en fase de producción comercial mediante la clonación molecular y su expresión, a gran escala.

Nuestros conocimientos moleculares sobre las enfermedades hereditarias son mucho más recientes. En estas el defecto genético ocasiona la función anormal de una proteína específica. Con todo el incremento en las investigaciones que ha ocurrido en los últimos veinte años, ha sido posible el entendimiento al nivel molecular de muchas enfermedades, incluyendo las no genéticas. En este sentido la caracterización de ciertas proteínas que aparentemente faltan o no funcionan correctamente, ha abierto el camino para una potencial estrategia terapéutica en el tratamiento de algunas enfermedades en las que estas proteínas juegan un papel importante.
Las nuevas vacunas
En todo el mundo, desde principios de la década de 1980, laboratorios y científicos investigan el desarrollo de nuevas vacunas que se espera, reemplazarán en un futuro a las tradicionales actualmente empleadas. Estas nuevas vacunas son producidas por la Ingeniería Genética, basadas en la molécula de DNA y en las secuencias de aminoácidos que contienen la información genética con la cual el organismo patógeno produce la enfermedad. La primera vacuna recombinante para uso en humanos fue la vacuna contra la hepatitis B. Actualmente, las investigaciones se centran en mejorar las vacunas ya existentes para lograr respuestas inmunitarias más eficaces, nuevas vías de administración y en la aplicación de vacunas combinadas (varias vacunas en una sola dosis) para reducir el número de inyecciones. El descubrimiento y decodificación de los genomas de bacterias y virus patógeno llevado a cabo en los últimos años, ha abierto una enorme esperanza en el desarrollo de estas nuevas vacunas. Actualmente existen una gama de protocolos para obtener vacunas. Así las vacunas con base en la técnica del DNA pueden incluirse en una de de las siguientes estrategias:
Vacunas atenuadas: mediante técnicas de Ingeniería Genética, se pueden eliminar los genes de virulencia de un agente infeccioso manteniendo la habilidad de provocar una respuesta inmune. En este caso, el organismo modificado genéticamente puede usarse como una vacuna viva sin riesgo a que revierta al tipo virulento. En la actualidad, se encuentra en fase de ensayos clínicos una vacuna de cepas estables del agente del cólera (Vibrio cholerae). El mismo, está desprovisto del gen que codifica para su potente enterotoxina que provoca la enfermedad. En el caso de Salmonella se ha ensayado quitarle ciertos genes que aunque no están relacionados con la virulencia, al desaparecer convierten la cepa en atenuada (disminución de su virulencia en un millón de veces). Se ha demostrado su efectividad en ovejas, bovinos, pollos y, más recientemente en humanos.
Vacunas vectores o de organismos recom-
binantes vivos: estas, utilizan microorganismos no patógenos (virus o bacterias) a los cuales se les incorporaron, mediante Ingeniería Genética, genes de agentes patógenos que codifican para los antígenos que desencadenan la respuesta inmune. El virus vacunal es uno de los vectores recombinantes más utilizados en este tipo de vacunas, ya que tiene un genoma grande, totalmente secuenciado y permite acomodar varios genes foráneos en su interior. De esta manera, se ha desarrollado una vacuna contra la rabia al insertar en el genoma de este virus, un gen del virus rábico; este construido provoca la respuesta inmune en el organismo hospedador. También se han ensayado las expresiones de genes que codifican para antígenos de virus de la hepatitis B, de la gripe y del herpes simple. Mediante este método, se podrían desarrollar vacunas que inmunicen simultáneamente para varias enfermedades, al insertar en el virus recombinante varios genes de distintos organismos patógenos al mismo tiempo.
Virus vivos recombinantes: los Paramyxovirus
son una familia de virus que incluye agentes de enfermedad comunes como sarampión, paperas y parainfluenza. La estructura genómica de estos virus es tal, que se le podrían insertar genes adicionales que codificasen una amplia variedad de proteínas de fuentes diferentes. Así el virus del sarampión ofrece varias ventajas como portador de genes que provoquen respuesta inmune contra otras enfermedades al mismo tiempo. Con tecnologías recombinantes se hace posible extender el rango de enfermedades contra las que una sola cepa atenuada del virus puede conferir inmunidad.
Vacunas de subunidades: para aquellos
agentes infecciosos que no se pueden mantener en cultivo, es posible aislar los genes que codifican para las proteínas que provocan la respuesta inmune (por ejemplo, las proteínas de las cápsides). Mediante Ingeniería Genética, esos genes se pueden clonar y expresar en huéspedes alternativos tales como bacterias (Escherichia coli), levaduras (Saccharomyces cerevisiae) o líneas celulares de mamíferos. Luego de insertado el gen de interés, la bacteria o levadura recombinante comienza a producir subunidades de proteínas en grandes cantidades, las cuales son recolectadas y purificadas para utilizarlas como vacunas. La vacuna contra la hepatitis B fue la primera vacuna puesta en el mercado producida por este método. Esta vacuna se desarrolló aislando el gen del virus que codifica para el antígeno HBsAg que provoca respuesta inmune. El gen que produce esta proteína se introdujo por clonación en plásmidos de expresión de levaduras (S. cerevisiae). Una vez construido, el antígeno se produjeron en grandes volúmenes en fermentadores industriales y de un modo seguro. En la actualidad, se está avanzando en vacunas de subunidades frente al virus del herpes simple (HSV), y la fiebre aftosa.
Vacunas de DNA: son las vacunas actualmente en experimental que suscitan mucha expectativa. Estas consisten en plásmidos en los que se introduce tan solo la pequeña fracción del material genético del patógeno contra el que se pretende inmunizar (los genes que codifican la producción de uno o varios de sus antígenos). Cuando se inyecta el plásmido en el músculo o en la piel, este penetra dentro de la célula y llega al núcleo, para comandar desde allí la producción de los antígenos del patógeno que desencadenarán la respuesta inmune. De esta forma lo que se hace es trasladar la fábrica de la vacuna a los tejidos de la misma persona. Actualmente, se están realizando ensayos de varias vacunas de este tipo, para la hepatitis B, la malaria, la gripe, el herpes simple y el SIDA/VIH. Vacuna de DNA desnudo: en este tipo de vacunas se utiliza directamente una porción del DNA purificado que contenga el gen de la proteína que produce la respuesta inmune. Esta fracción de DNA se inserta en un plásmido. Las células del paciente vacunado captan ese plásmido y lo incorporan en su núcleo, permitiendo la expresión del gen foráneo y produciendo la proteína recombinante. Esta proteína es secretada al exterior de la célula, por lo cual el sistema inmune puede reconocerla de la misma manera que durante una infección natural, induciendo una respuesta inmune.
Como se vio anteriormente, para el diseño de las nuevas vacunas se parte del conocimiento detallado del genoma del patógeno. Con esta base, se inactivan selectivamente solo aquellos genes no deseados implicados en virulencia, o se potencian aquellas características de inmunogenicidad favorables para la preparación de la vacuna. Al conocer en detalle la composición molecular de la vacuna, se garantiza su seguridad y estabilidad, eliminado los posibles riesgos de introducir microorganismos vivos atenuados. Otras ventajas incluyen la ausencia de riesgos en su producción a escala industrial, ya que no se trabaja en ningún momento con organismos patógenos. En la actualidad se están llevando a cabo investigaciones en vacunas contra el virus del papiloma Humano HPV (algunos subtipos podrían vincularse con el cáncer de cuello de útero), la malaria (enfermedad que mata a casi tres millones de personas por año), el citomegalovirus (que provoca un síndrome similar a la mononucleosis), la Shigella una bacteria que produce diarrea, el herpes y enfermedades parasitarias como la toxoplasmosis. También se están probando vacunas contra el HIV (virus que causa el SIDA), y contra el cólera o el dengue, y varios tipos de cáncer. Además del desarrollo de nuevas vacunas, también se están mejorando algunas ya existentes, como la vacuna contra el neumococo (causante de neumonía y meningitis), que abarcará más serotipos de este microorganismo que las vacunas actuales. Al mismo tiempo, se están estudiando vías de administración nuevas, como la nasal (a través de las mucosas) o intradérmicas (en la piel, aunque sin pinchazo). Otra opción muy interesante la constituyen las vacunas que podrían ingerirse con los alimentos o «vacunas comestibles».
Organismos transgénicos
Las técnicas de manipulación genética de la biotecnología moderna han hecho posible modificar la información genética de una serie de organismos animales, apelando a diferentes técnicas y con diferente propósito y resultados. Un organismo transgénicos es aquél que ha sufrido la alteración de su material hereditario (genoma) por la introducción artificial (manipulación genética) de un gene exógeno, esto es, proveniente de otro organismo completamente diferente. Los organismos transgénicos muestran que aparentemente no existen barreras para mezclar los genes de dos especies diferentes. A mediados de los años sesenta se comenzaron a desarrollar bio-herramientas moleculares con las cuales se podía componer y descomponer al DNA, lo que permitió intercambiar fragmentos específicos de DNA de distintas especies e incluso transferirlos a microorganismos como las bacterias. Después se descubrió que esta práctica la venía haciendo la naturaleza desde hace millones de años con los vegetales a través de la bacteria llamada Agrobacterium tumefaciens.
Animales biofábrica
Un animal biofábrica es aquel al cual se le ha introducido una información genética que le permite sintetizar una determinada proteína por transgénesis. Lógicamente la expresión del gene se efectúa clonándolo en vectores de expresión que contengan promotores y elementos de control de la transcripción que puedan controlar la expresión del gene en un determinado órgano.
Afiliaciones y notas
* Doctor en Ciencias y PDPH. Profesor titular del Departamento de Ciencias Fisiológicas de la Escuela de Ciencias Básicas, Facultad de Salud, Universidad del Valle.
** Magíster en Ciencias con mención en Microbiología. Investigadora en Biología Molecular.
*** PhD y profesor asistente del departamento de Ciencias Fisiológicas de la Escuela de Ciencias Básicas, Facultad de Salud, Universidad del Valle.
Cómo citar este artículo
García Vallejo F, Domínguez MC, Sánchez A. Aplicaciones de la biología molecular en la salud humana - I Parte. Rev Col Menop. 2012;18(3):179-198.
García Vallejo, F., Domínguez, M. C., & Sánchez, A. (2012). Aplicaciones de la biología molecular en la salud humana - I Parte. Revista Colombiana de Menopausia, 18(3), 179–198.
El archivo RIS se importa en Zotero, Mendeley o EndNote. Revisa los nombres de los autores: la cita se arma automáticamente a partir del artículo.